← 全部作品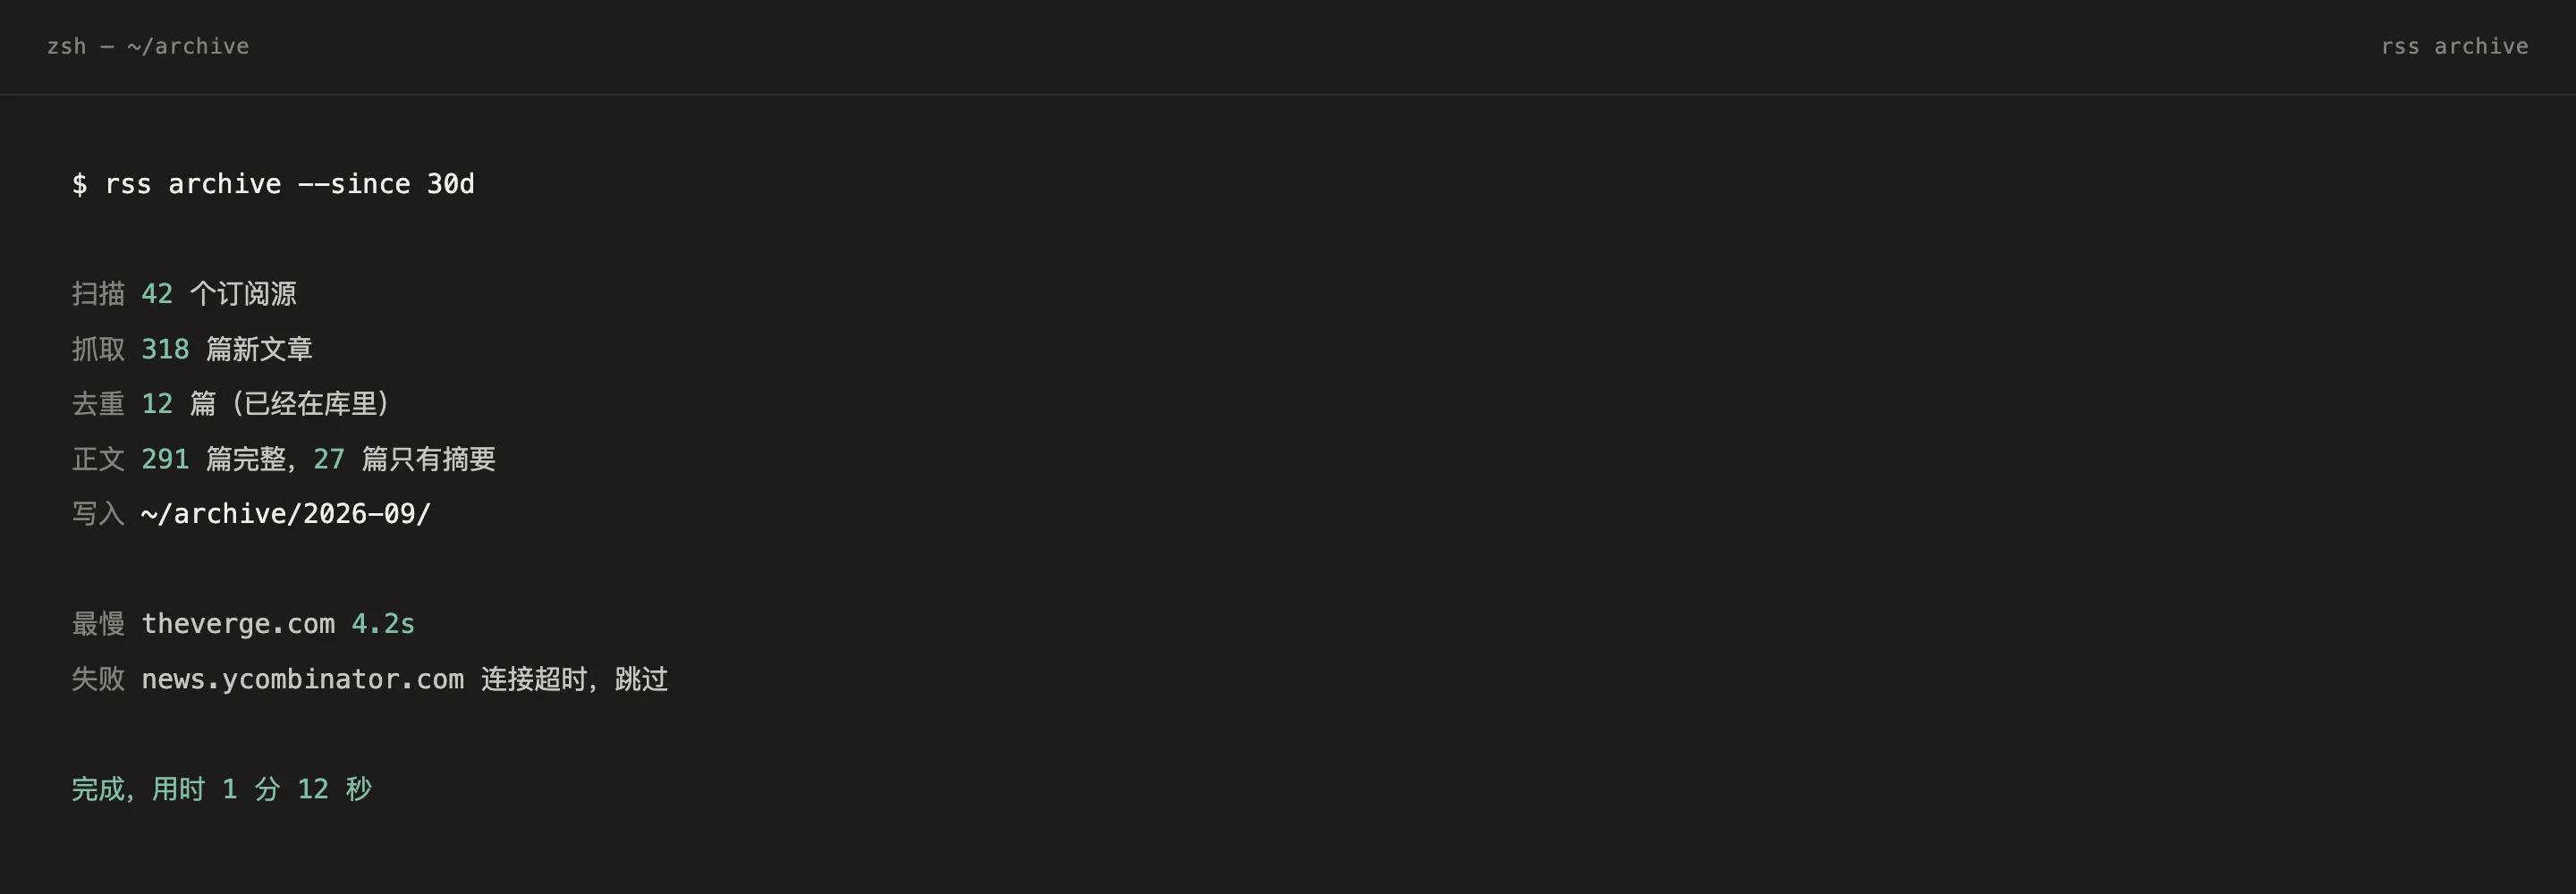
一次真实的运行记录,省略了中间过程的输出。
归档器
把订阅源的全文抓下来存成本地文件,不依赖任何在线服务
为什么做
我订的源有四十多个。早年存下来的链接,现在一半已经打不开了。
一开始我用的是现成的稍后读服务,用了两年,服务关掉了,导出来的文件只有标题,正文全没了。那之后我就想明白一件事:只要东西存在别人的服务器上,它就不算我的。
所以这个工具只做一件事——把全文抓下来,连同正文、图片地址和原始链接,一起写成本地文件。它不需要登录,不需要联网校验,断网也打得开。
关键的取舍
不做全文检索。 中间版本里我塞过一个索引,后来发现用系统自带的文件搜索就够了。四十个源的量根本用不上专门的索引,少一个依赖就少一处会坏的地方。
失败就跳过,不重试。 抓不到就记一行,下次再跑。全流程重试会让一次运行从一分钟拖到十分钟,而绝大多数失败是站点本身的问题,重试也一样没用。
只有摘要的那些也留下。 我本来想直接跳过,后来发现哪怕是摘要也比什么都没有强——一年后回头看,摘要至少能让我想起来当时为什么存它。
存原始 HTML,不只存纯文本。 文件大一倍,但十年后我还能重新提取。纯文本是此刻的我的判断,HTML 是原文。
现在
每天凌晨跑一次,已经连着跑了九百多天。库里大概四万篇,占 11 GB。
失败率在 2% 上下,集中在几个反爬比较凶的站点。我一直没去处理,因为剩下的 98% 够用了。
回头看
动手的时候我以为最麻烦的是抓取,其实最难的是去重——同一篇文章在十个源里出现,标题可能都不一样。最后我用的是链接加正文前 200 字的哈希,很土,但这三年没出过问题。
如果再写一次,我会把源配置和抓取逻辑拆开。现在它们混在一个文件里,加一个源要改代码,这是当时图省事留下的债。
Go · 单文件二进制 · 没有数据库依赖 · 源码不公开